| 中科曙光发布FN Neo:AI推理时代,集中式存储被重新认识 分享到: |
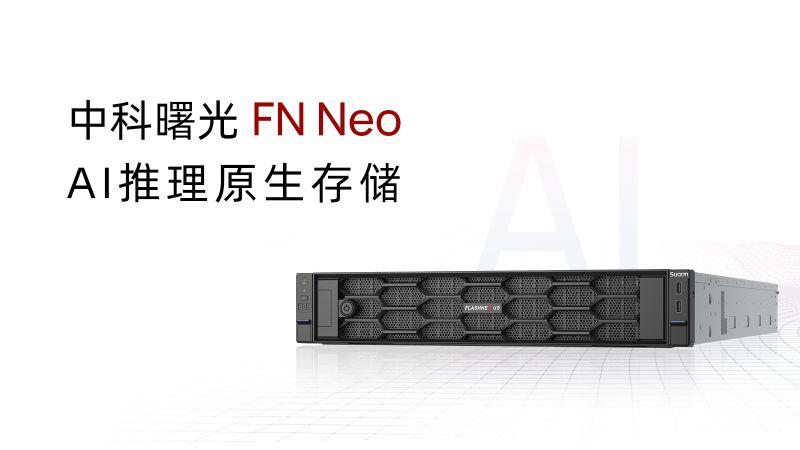
智能体时代加速到来,AI推理业务规模快速扩张。不久前,中科曙光在2026年CCF全国信息存储技术学术会议上正式发布全新迭代升级的AI推理原生存储FN Neo,依托池化共享架构,实现集群级KV Cache资源调度,为AI推理规模化落地提供全新存力底座。
集中式存储适配AI推理新场景
从市场数据看,推理需求正在快速走高。据IDC预测,未来3年AI计算资源使用情况将从当前训练占80%、推理占20%,转变为训练占20%、推理占80%。Token正在成为新的生产材料,单位token成本成为推理盈利的关键。
训练决定模型能力的上限,推理决定商业回报的下限。当AI进入商业化阶段,推理成为直接面向用户、持续发生、直接产生成本与收入的主要场景。过去业界关注“模型训练得多快”,如今逐渐转向关注“模型服务得多快、规模有多大、成本有多低、运行有多稳定”。
在大模型与Agent业务场景下,KV Cache已经成为推理环节的核心生产数据。然而,传统节点本地缓存模式资源割裂,难以实现跨会话、跨节点复用,制约大模型推理整体效能。
行业内存在“集中式存储不适合AI推理”的惯性思维,不少从业者认为推理业务更依赖本地盘的性能表现。事实上,集中式存储的池化共享架构,早已在金融、通信等对稳定性要求严苛的关键业务中经过大规模实践验证,这套成熟能力同样可以迁移到AI推理领域。
中科曙光集中式存储产品部总经理郭照斌表示,大规模超算中心后端实际上用的就是集中式硬件,针对AI存储推出的产品,行业广泛采用集中式硬件叠加横向扩展、纵向扩展和协议处理能力。
“在后端硬件上,无论是服务器还是双控阵列,在当前AI数据中心里都占有一定比重,并行存在,不需要去纠正用户的使用习惯。”郭照斌说。
在传统推理部署方案中,KV Cache属于计算节点的私有资源,不同会话之间无法互通,大量宝贵缓存数据被闲置,算力资源难以充分释放。本地缓存受单卡、单机硬件边界束缚,极易出现GPU显存溢出、资源浪费的问题。中科曙光此次推出的FN Neo立足集中式全闪架构,跳出单节点硬件局限,用统一存储池承接推理业务各类数据诉求,证明集中式存储完全可以胜任高并发、低时延的AI推理复杂负载。
池化共享实现KV Cache集群级调度复用
FN Neo的核心突破在于集群级KV Cache池化共享能力,将原本绑定在各个计算节点内部的私有缓存,转变为整个推理集群可调度的共享资源。
这意味着推理缓存不再依附于单台服务器,不同模型会话、不同计算节点之间能够灵活读取、复用KV Cache数据。集中式存储的价值也由此拓展,从过去主要承载模型权重、业务文件等传统数据,进一步延伸到推理运行时缓存这一动态高频场景,打通大模型推理性能优化的关键一环。
郭照斌表示,智能体出现之后,最显著的变化是上下文持续。一个智能体作业应用,用户输入一条命令后,智能体会产生一系列连续任务。连续任务对推理应用来说就是持续连续的上下文,如果持续上下文短缺,GPU就会重复计算,成本非常高。特别是在AI Coding工程中,工程量较大,上下文规模很大,“KV Cache如果不卸载,即使算力再强,Token输出效率也会非常低”。
KV Cache的角色随之改变。它不再只是推理过程中的临时缓存,而是开始具备数据资产的特征:有生成成本、复用价值、生命周期,需要管理和跨节点共享。
郭照斌表示,除了KV Cache本身,推理过程中还有模型参数、容器环境、共享数据等需求,都对存储提出了新要求。“中科曙光希望通过存储,通过存力来解决算力的重复计算。”他说。
快、稳、开放缺一不可
FN Neo延续了中科曙光高端集中式存储的高性能基因。实测数据显示,其单阵列带宽可达160GB/s、亚毫秒级时延,延迟表现、吞吐量和多请求并发数相比传统本地NVMe方案均有约2倍提升。
单节点测试中,8卡计算节点运行DeepSeek-R1-Distill-Llama-70B,FN Neo的KV Cache卸载能力带来7至12倍不同上下文性能提升;多节点双节点集群运行Qwen2.5-32B-Instruct,提升达6至10倍。
作为专为AI推理打造的集中式全闪存储,这套方案更可实现模型首Token响应时间缩减73%,整体Token吞吐能力提升150%,显著改善用户交互体验。
面向生产级AI业务,仅有性能突破远远不够,稳定可靠与生态适配同样不可或缺。据了解,AI长程推理对尾延迟非常敏感,存储在推理链路中不仅要追求平均快,更要提供稳定、可预测的低延迟。FN Neo具备99.999%高可靠运行保障,通过慢盘自动隔离、故障无损重构等机制,保障推理业务7×24小时不间断运行。
FN Neo提供原生SAN、NAS、KV三协议一池直出。郭照斌说,相比在NAS上叠加SAN和KV,或在SAN上叠加NAS再叠加KV,直出协议的协议栈最短、延时最低,每个协议都能达到阵列的极致性能。三个协议共用后端硬盘资源,文件删除后腾出的空间可以继续给块协议或KV协议使用,资源调度灵活。
据介绍,支撑这一架构的是中科曙光积累二十多年的超级隧道技术。郭照斌解释,资源共享带来灵活性的同时也会引起竞争,超级隧道解决两类竞争:一是硬件资源竞争,将CPU核心、内存、网络、硬盘构成快速资源线,做到隔离独立;二是软件竞争,去掉不可控的操作系统,自定义内存操作、协程操作、无锁原生语义脉冲和看板机制。
开放生态方面,FN Neo兼容vLLM、SGLang、LMCache、HiCache、Mooncake等主流推理框架,适配RoCE/IB/国产400GIB/FC/IPSAN多种组网,兼容多种主流操作系统。郭照斌强调,FN Neo提供全用户态客户端组件,无内核模块嵌入,对计算节点影响小,企业无需大规模改造现有推理环境即可完成接入。
追求极致性价比是出发点之一
存储成本正在成为AI推理落地的重要考量。郭照斌坦言,近一年国际市场的存储价格大幅上涨,对中小企业而言,私有化部署推理时,如果存储起步配置过高,成本压力明显,因此FN Neo的设计出发点之一就是极致性价比。
基础款为2U25盘位双控阵列,搭载两颗国产高主频CPU,支持IB网络和曙光自研的原生RDMA协议和RoCE协议。郭照斌说:“一套存储或一台存储,就能解决中小应用的本地化部署超级节点,或者10台20台算力卡独立算力集群的存储需求。”
算力基础设施的投资,也在从算力规模扩张转向算力与存力协同。存储成本的优化,直接关系到算力资源的利用效率。
FN Neo支持横向和纵向扩展,并在全局统一命名空间下实现,这极大增强了扩展能力。与此同时,NAS共享能力带来显著的经济性。传统计算节点搭载本地SSD,计算与存储共用有限的CPU和PCIe通道,服务器性能约7GB/s,容量难以扩展,存算一体难以跨机共享。FN Neo提供可共享的NAS存储能力,单卷文件系统协议可达70GB/s,块协议可达160GB/s,访问能力较本地盘提升10倍以上。10个节点原本每个节点都要存放一份模型数据,使用共享存储后,可节省9倍存储空间,单节点加载带宽较本地盘提升9倍,且能力可线性扩展。
郭照斌透露,在AI Coding场景下,上下文持续增长且规模大,FN Neo做KV Cache卸载的效果最明显,首token延时可提速12倍以上。
在郭照斌看来,存储当前能力提升和发展的方向,始终围绕计算和应用变化。“FN Neo已经很好地满足当前AI推理对于存储的所有需求和能力,它也应该会作为用户比较好的选择方向。”他说。来源:中国发展网 记者崔立勇报道
|
| 上一篇:没有了 下一篇:2027深圳国际数据存储展览会将于6月1 |
版权所有:上海、北京、深圳国际数据存储展览会组委会
联系人:潘老师 先生 手机/微信:188-0182-3515 沪ICP备20019626号-6
商 务 QQ : 916984267 E-mail : 916984267@qq.com